•ᴗ•这里是我的收藏。🍳
dandism dandism 2026年10月09日
卧槽,Grok Bot 这波更新有点狠!🔥
直接解锁了「实时搜索、阅读与监控 X」的能力,原生的最
dandism卧槽,Grok Bot 这波更新有点狠!🔥

直接解锁了「实时搜索、阅读与监控 X」的能力,原生的最强信息雷达来了。

📌 划重点:

👉 面向所有用户开放

👉 零门槛:完全不需要繁琐的 X 连接器设置(不用花钱用自己的 x api 了)

我脑海里冒出的第一个神仙用法:

直接让它 7x24 小时监控

@thsottiaux

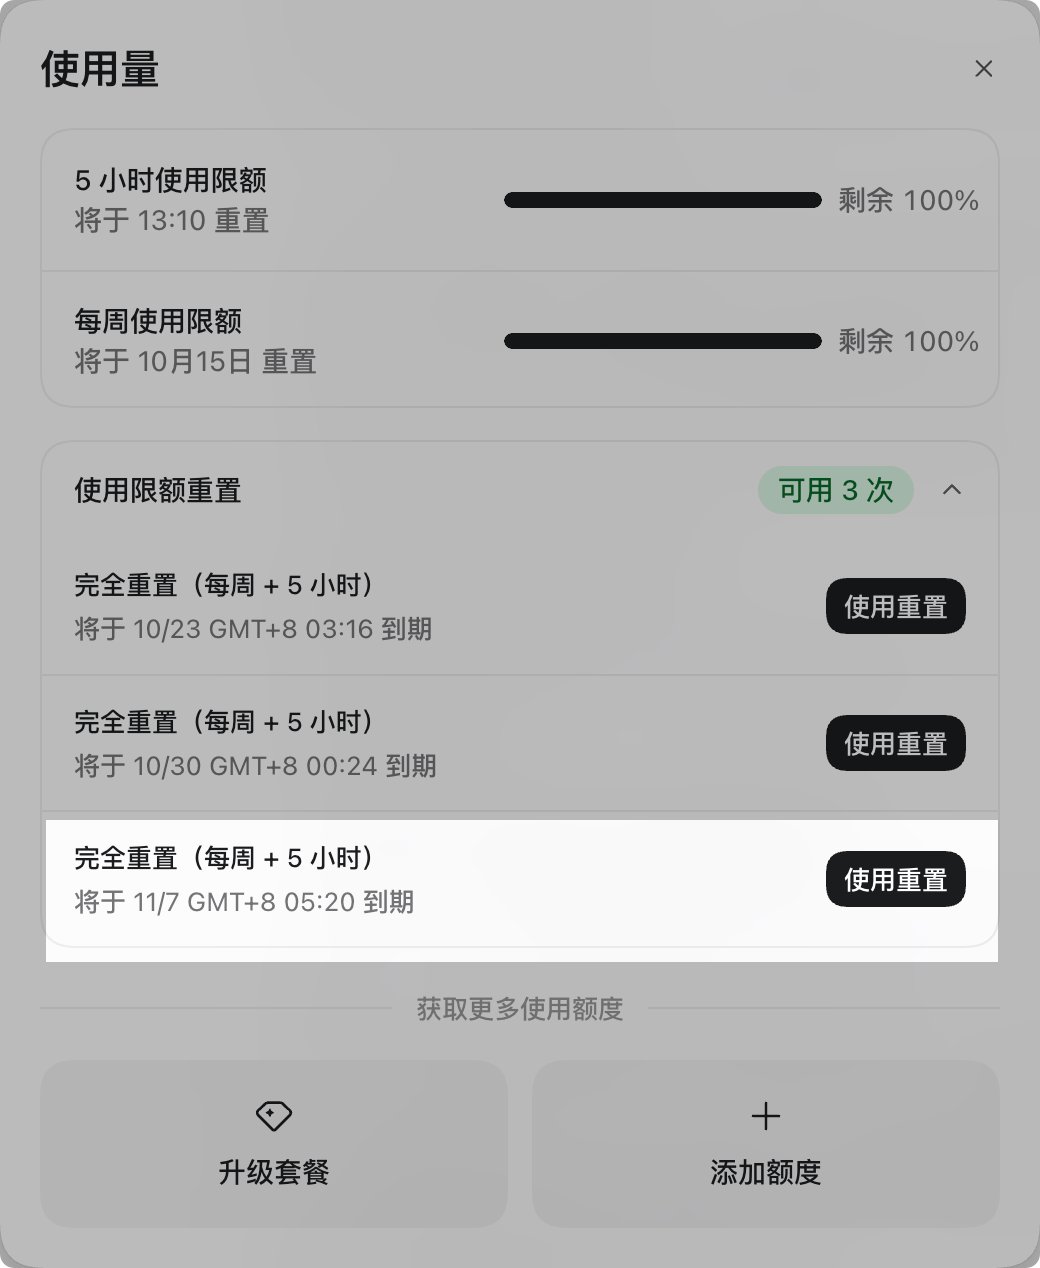
盯紧 ChatGPT 的重置动态。👀

这相当于自带了一个全天候盯盘的超级情报员。

Personal Agent 的下注,已经在快速滑向 Grok Bot 。
dandism dandism 2026年10月09日
dandism让 Grok bot 每天早上定时出一个 AI 早报的视频,没想到效果还真挺不错的!

全程都没用我本地电脑,全跑在它的云端虚拟机上,包括内容收集、写代码和视频渲染。

我写了个提示词,直接复制过去的话,你的 Grok bot 也能执行这些任务

提示词太长放下面了
dandism 作者 提示词:

把里面的 @<你的用户名> 和"其他来源"换成对方自己的

请帮我搭一套「AI 早报 + 讲解视频」流程:每天整理前一天的 AI 资讯,出一份文字简报,再做成一条约 90 秒的中文讲解视频。先装好环境,用昨天的内容试跑一期,交给我验收。

【一、安装 skill(在你自己的电脑上)】
把下面三个公开仓库克隆到 ~/.claude/skills/ 下,每个都完整读一遍 SKILL.md 和它引用的文件:
- https://github.com/op7418/guizang-product-video-skill (视频制作流程:React + GSAP 搭画面,Playwright 逐帧渲染,FFmpeg 合成)
- https://github.com/op7418/guizang-social-card-skill (版式:瑞士风,纸白底,安全橙 #FF6B35)
- https://github.com/op7418/Humanizer-zh (旁白去 AI 腔)
按 skill 的环境检查把缺的依赖装齐(Node、Playwright + Chromium、FFmpeg、Python 等)。另外装 edge-tts 做中文配音,可以先用 zh-CN-YunxiNeural,语速 +20%;有更稳定的 TTS 也可以换。

【二、采集资讯(日期 Y = 我所在时区的昨天)】
- 时间窗口用我所在时区的完整一天,换算成 UTC 再查,不要直接用 UTC 零点。
- 来源:我的 X 收藏、我自己在 Y 当天发的推文(按 赞 + 2×评论 + 2×收藏 取前 3,附上评论区里有实质内容的观点),以及我下面列出的其他来源。
- 我的 X 账号:@<你的用户名>
- 其他来源(可选):<比如某个 newsletter 的发件邮箱、某个网页>
- 某个来源读不到时,如实写"没读到",和"没更新"分开写。

【三、文字简报】
- 把相关内容归成 5–7 条主线,每条一句话标题,加一两句要点,带上关键数字。
- 每条都要附原推链接 https://x.com<用户名>/status/<id>,补过背景的再附一个官方来源。
- 价格、跑分、融资额这类数字要回官方页核对。传言标"未证实/社区传言"。绝不编造数字、引用、链接或用户名,评论作者按推文 id 回填。

【四、讲解视频】
- 完全按 Product Video skill 的流程做:先写 DIRECTION.md,再搭镜头,最后渲染。画面的字体、配色和排版沿用社交卡片 skill。
- 结构:片头(AI 早报 + 日期 + 今日条数)→ 每条新闻一屏(标题、1–2 个橙色关键数字、来源账号)→ X 雷达一屏 → 片尾。总长 60–90 秒,默认横屏 1920×1080。
- 旁白中文口语化,先用 Humanizer-zh 过一遍。每句单独合成配音并量出时长,镜头、字幕和动作时间都按实际配音时长来对齐。字幕烧录进画面,人声出现时把音乐压低。
- 视频里只放简报里已经有的事实,不新增内容。
- 导出后跑 skill 自带的交付检查,抽帧逐屏看:文字不能溢出、重叠或截断,中文不能缺字,整片色调要统一。有问题先改完再交。

【五、交付】
发给我:文字简报全文、成片 mp4、旁白稿、3–4 张关键帧,再加一句话说明哪些步骤还不稳定。不要替我发任何消息或帖子。

试跑我满意之后,再帮我建一个每天早上 9 点自动跑的定时任务。
Mybro Mybro 2026年10月08日
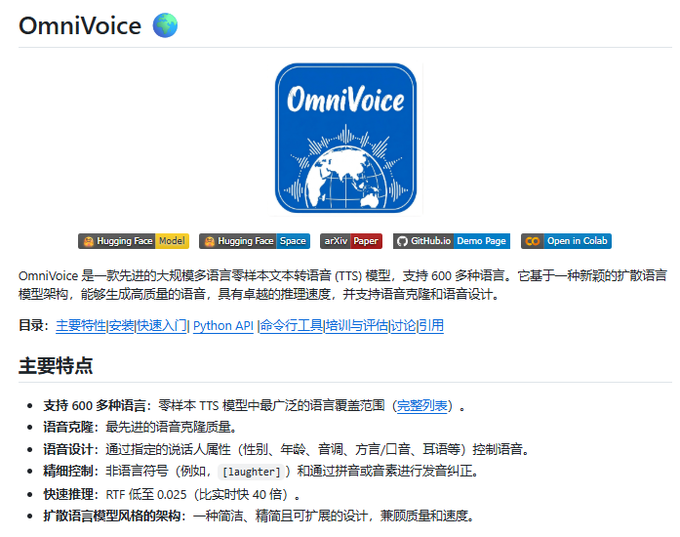
最近刷到一个开源声音复刻项目,挺生猛:OmniVoice。
Mybro最近刷到一个开源声音复刻项目,挺生猛:OmniVoice。

丢一段参考音频进去,不用提前训练,就能生成接近原声音色的语音。

几个比较亮眼的点:

① 600+ 种语言都支持
② 年龄、音高、方言、气声这些特征可调
③ 零样本声音复刻,拿来就能试
④ 生成速度最高能到实时的 40 倍
做配音、多语言内容的,或者研究 TTS 的,可以拿来玩玩。
🔗 https://github.com/k2-fsa/OmniVoice
Web3 天真 Web3 天真 2026年10月08日
Web3 天真在 RTX4080 上实测了下 FastH3 V2,确实快不少

相同完整提示词、640×640、8 秒、种子 20261007;
左边 FastH3 V2:58.23 秒;
右边官方 MiniMax H3 INT8:255.92 秒

画面质量感觉也差不多,就算不看画面质量,算下来8秒不到生成1s视频,这个效率提升单纯拿来抽卡调测也很香啊!
幸运的路克 FastVideo FastH3 现在可在单台消费级显卡上运行了FastH3 V2 一段 5 秒 480p 带音频的片段
在 RTX 5090 上仅需 15 秒
还有 FastH3 Trim 能很好的运行在8G显存的显卡上
https://huggingface.co/FastVideo
taketo taketo 2026年10月08日
taketo这波有点像2016年的电商红利
这个Luna的虚拟女生,几天就能干到上亿播放
而且制作门槛低到膝盖以下!!

步骤1:去 Pinterest 找个有记忆点的怪角色,丢给 ChatGPT 做成固定角色卡
步骤2:找一条已经跑出来的爆款视频,在 Claude 里直接调 Seedance 2.5 API,把里面的人换成自己的角色

提示词可以这么写:
“把视频里的人物换成这张角色图,动作、镜头、构图、光线、调色和整体质感都按原视频来。”

后面要改角色、换风格、调动作,继续在 Claude 里改就行。
搜索
🔍 搜索
🎨 主题模式
分类
所在位置
谁可以看
公开所有人可见
私密仅自己可见
广告内容
播放列表

暂无歌曲